インタビューや会議の録音を、外部の文字起こしサービスに上げてよいのか。
倫理審査や契約で「ダメ」と言われた人は多いはずです。
この記事では、ローカルAI構築キットで作れる「音声議事録」機能の操作手順を、自動生成マニュアルの画面で解説します。
faster-whisperによる文字起こしから、要約・決定事項・ToDo・発言要旨の4構成の議事録生成、Word保存まで、すべてPC内で完結します。
1. 録音データは一番「外に出せない」データ
研究インタビュー、患者との面談、取締役会、顧客ヒアリング。
録音には、文書よりも生々しい個人情報と機密が入っています。
クラウドの文字起こしサービスは便利ですが、「この録音を外部サーバーに送ってよいか」という問いに、倫理審査や契約が「はい」と言ってくれないことは珍しくありません。
ローカルAI構築キットで作れるアプリには、この問題のために「🎙️ ローカル音声議事録」タブがあります。
文字起こしは faster-whisper、議事録の生成はOllamaのローカルLLM。
どちらもPC内で動き、録音はどこにも送られません。
この記事の画面は、キット同梱のプロンプトが自動生成した操作マニュアルのものです。
使っている録音は、Windows標準の音声合成で作った「架空ゼミの定例ミーティング」で、登場する人物・組織は実在しません。
2. ステップ1:音声議事録タブでモデルと言語を選ぶ
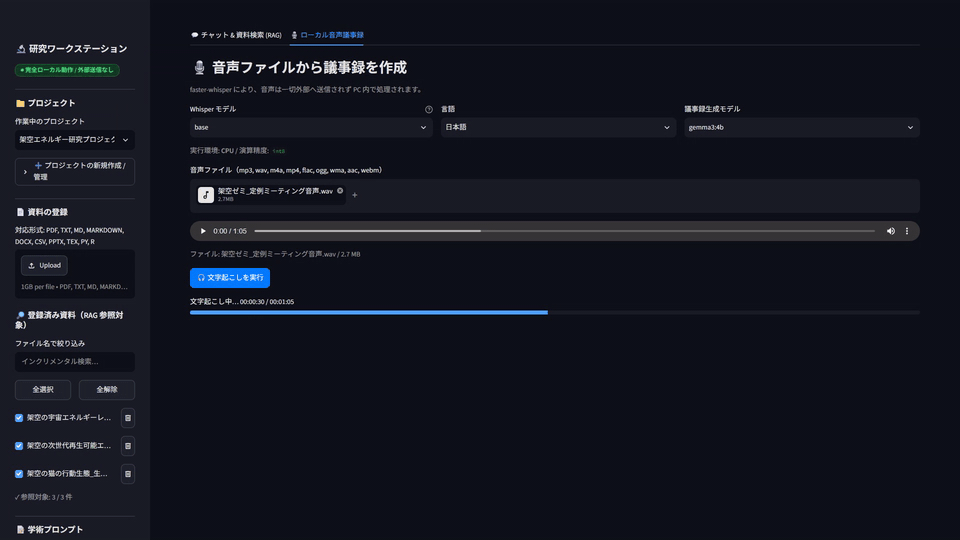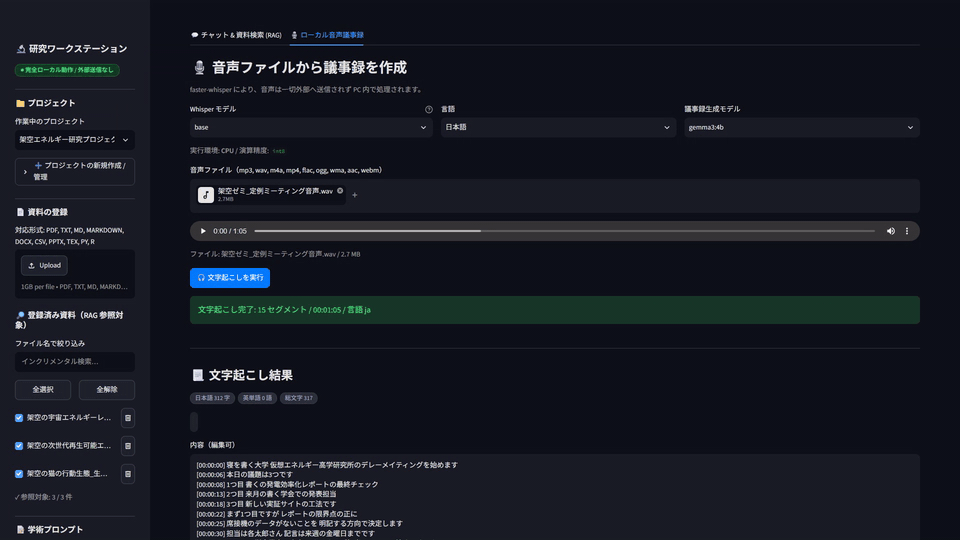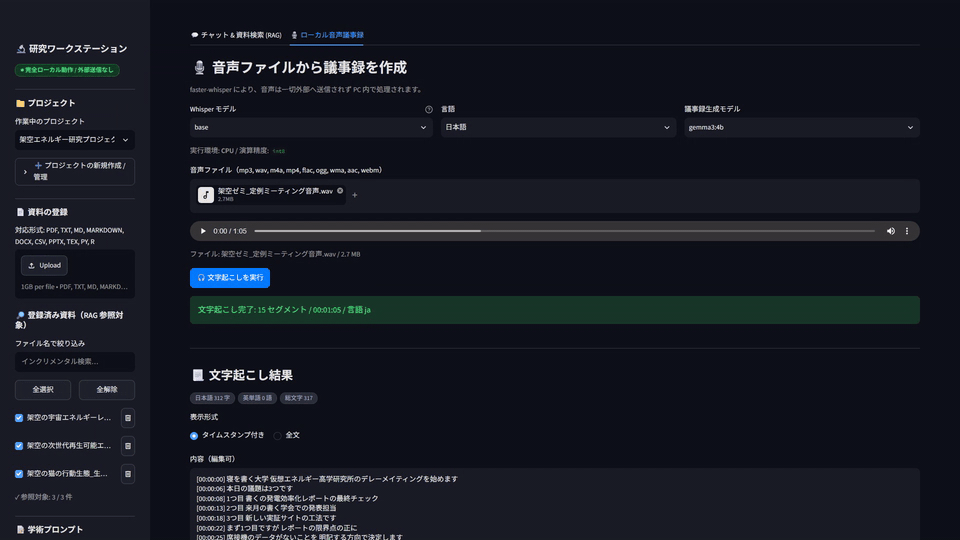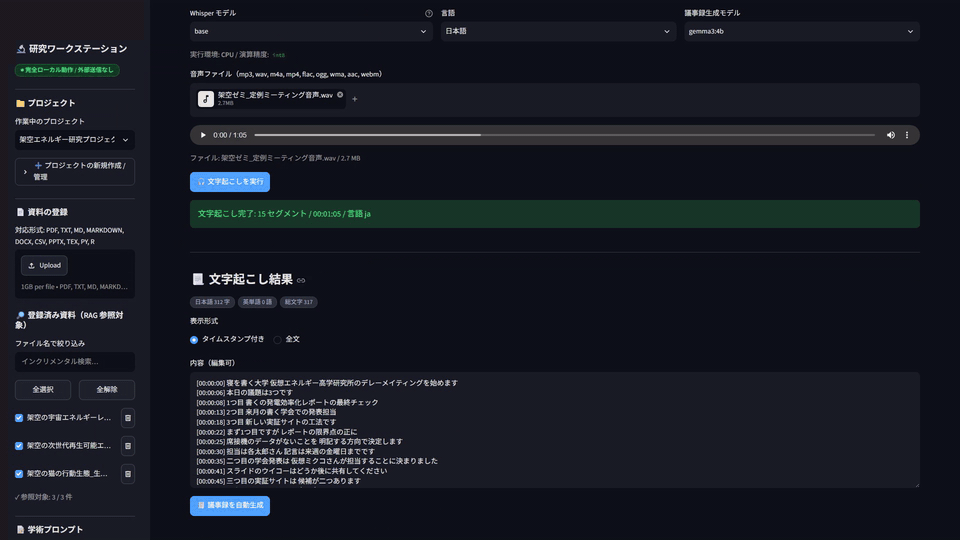
タブを切り替えると、上部に3つの選択肢が並びます。
- Whisper モデル: tiny / base / small / medium / large-v3。既定は base(高速)。固有名詞が多い会議は small 以上を推奨
- 言語: 日本語 / 英語 / 自動判定
- 議事録生成モデル: PC内のOllamaモデルから選択
その下に「実行環境: CPU / 演算精度」が表示されます。
NVIDIA GPUがあれば自動でCUDAを使い、なければCPUにフォールバックします。
3. ステップ2:音声をアップロードして文字起こしを実行
対応形式は mp3 / wav / m4a / mp4 / flac / ogg / wma / aac / webm です。アップロードすると、その場で再生できるプレイヤーとファイルサイズが表示されます。
「🎧 文字起こしを実行」を押すと進捗バーが動き、完了すると「文字起こし完了: N セグメント / 再生時間 / 言語」と表示されます。初回だけWhisperモデルのダウンロードが発生します(これがこの機能で唯一のネットワーク通信です)。
4. ステップ3:文字起こしを目で直してから議事録を生成
文字起こし結果は「タイムスタンプ付き」と「全文」を切り替えて表示でき、その場で編集できます。固有名詞の誤認識や言い淀みを直してから次へ進めるのがポイントで、編集後の内容が議事録生成に使われます。
文字数カウンタ(日本語文字数・英単語数・総文字数)もここに表示されます。
準備ができたら「🧾 議事録を自動生成」を押します。
5. 生成される議事録の4構成
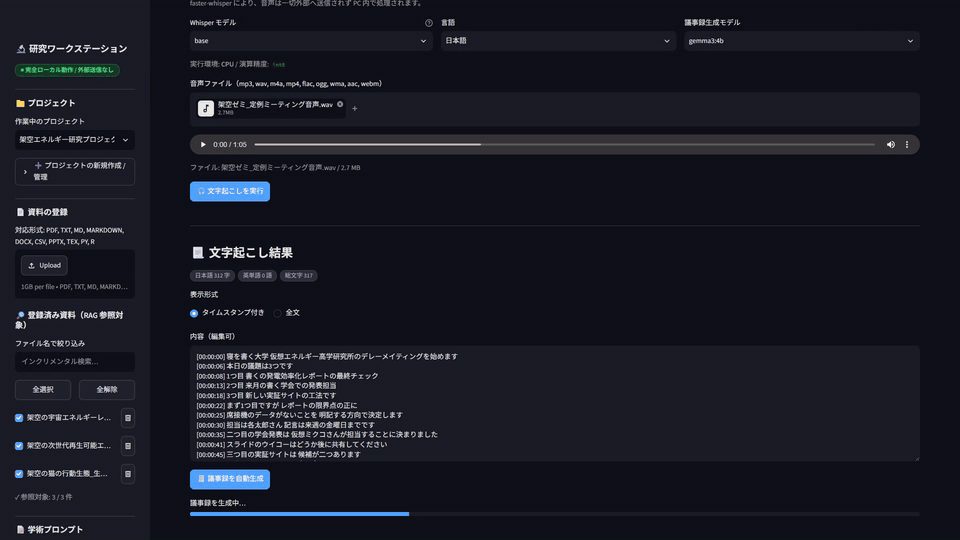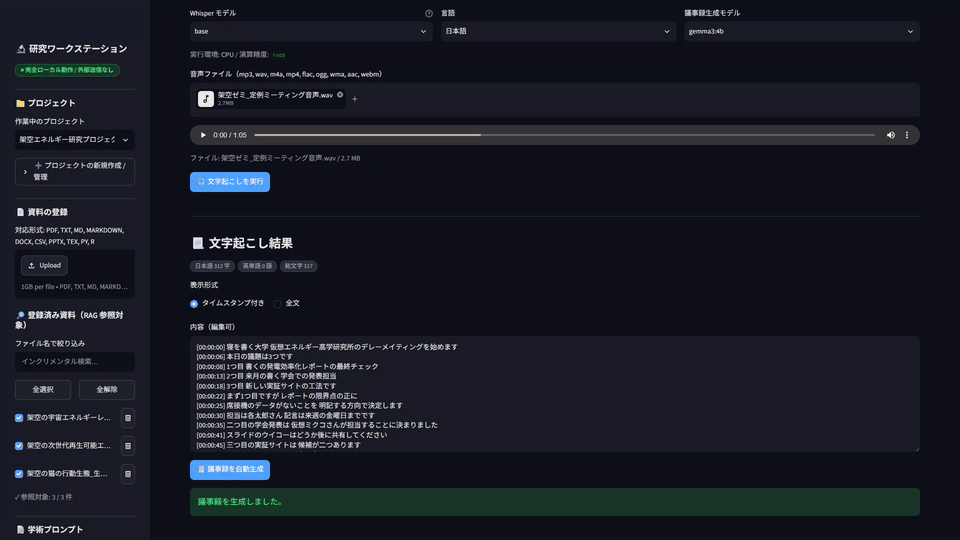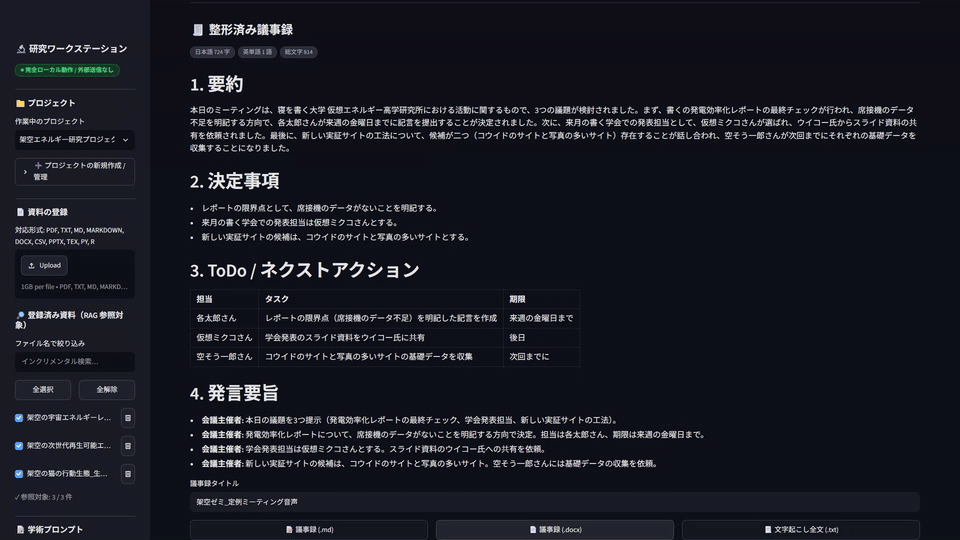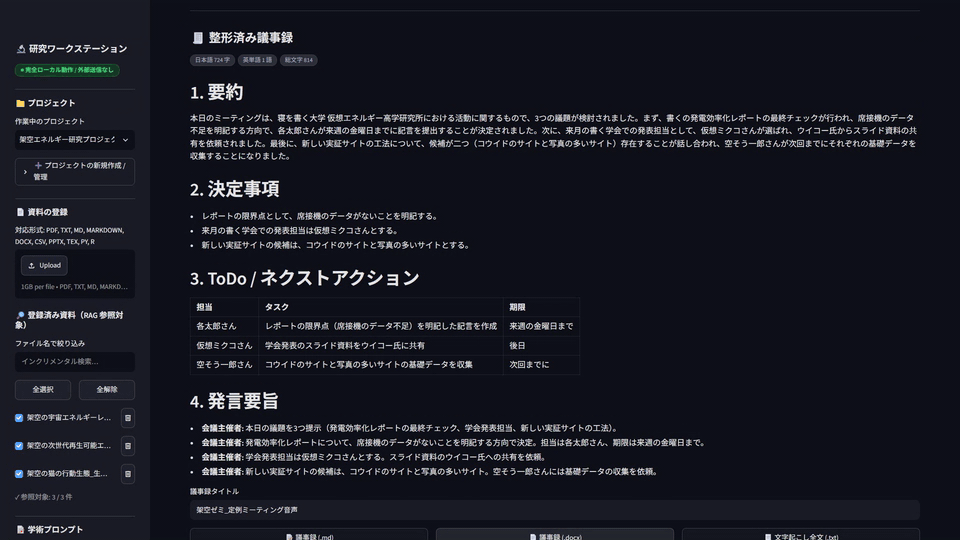
議事録生成のプロンプトは、文字起こしに書かれていないことを推測で補わないこと、不明瞭な箇所は「(聞き取り不明)」と明記することを厳守事項にしたうえで、次の4セクションを必ず出力させます。
- 要約(200〜400字)
- 決定事項(箇条書き。なければ「特になし」)
- ToDo / ネクストアクション(担当・タスク・期限の表。不明なら「未定」)
- 発言要旨(発言者または話題ごと)
架空ゼミの例では、「レポートの限界点の章に積雪期のデータが無いことを明記する」が決定事項に、「担当: 架空太郎 / 期限: 来週金曜」がToDoの表に入りました。会議のたびに同じ型で出てくるので、議事録のフォーマット統一にも効きます。
見出し構成を組織の書式に合わせたい場合は、キットの参照用コード audio_transcriber.py の議事録プロンプトを書き換えるか、アプリ構築プロンプトの「タブ2」の要件を変えてClaude Codeに再構築させます。
6. 保存と、保存済み議事録の管理
生成後は、タイトルを付けて次の3つをダウンロードできます。
- 📝 議事録 (.md)
- 📄 議事録 (.docx) ― Wordで開いてそのまま配布
- 📃 文字起こし全文 (.txt)
議事録はプロジェクトのSQLiteにも保存され、「📂 保存済みの議事録」から一覧・削除できます。バックアップスクリプトを実行すれば、DBごと日時付きフォルダに退避できます。
7. 精度と速度の調整:Whisperモデルのサイズ
CPUだけのノートPCなら、まず base で試し、固有名詞が気になれば small に上げるのが現実的です。長い録音は分割して読み込ませると待ち時間が読みやすくなります。
GPUがあれば medium や large-v3 も実用範囲です。
精度を上げるもう1つの方法は、ステップ3の手修正です。全文を完璧に直す必要はなく、議事録に出てほしい固有名詞と数字だけ直せば、生成結果は大きく改善します。
8. 自分の録音で試すには
キットの参照用コードをそのまま起動すれば、この機能はすぐ使えます。必要なのは Python 3.10〜3.12 と Ollama、そして ollama pull gemma3:4b(議事録生成用。別モデルでも可)です。faster-whisper は依存関係に含まれているので、追加のインストールはいりません。
コメント