1. 議事録の1時間はどこに消えているか
議事録づくりの作業を分解すると、こうなります。録音を聞き返す。聞き取れなかった箇所を巻き戻す。文字に起こす。決定事項とToDoを拾い出す。担当者と期日を表にする。体裁を整えて配布する。1時間の会議なら、慣れた人でも40分から1時間はかかります。これが毎週、場合によっては毎日発生します。
この記事で紹介するローカルAI業務アシスタントの2つ目のタブは、この作業のうち「文字に起こす」「決定事項とToDoを拾う」「体裁を整える」を自動化します。担当者に残るのは、生成された議事録を原文と突き合わせて確認する作業だけです。議事録に時間を取られている状況の整理は、課題別の記事 {P2} に書いています。
2. 録音データを社外に出さない、という前提
クラウドの文字起こしサービスは便利ですが、商談の録音には取引先名、金額、担当者名、場合によっては取引先の内部事情まで入っています。秘密保持契約を結んでいる相手との会話を外部サーバーに送ることは、現場の判断では背負えないリスクです。
このアプリの文字起こしは faster-whisper というライブラリを使い、PC内で完結します。音声ファイルが外部へ送信されることはありません。初回だけ音声認識モデル(約145MB)のダウンロードが発生しますが、このときも音声データ自体は送られません。2回目以降はPC内のモデルを読み込むため、完全にオフラインで動きます。
3. 操作①:音声ファイルを入れて文字起こしを開始する
画面上部の「🎙 商談・ミーティング音声議事録」タブに切り替えます。手順は4つです。
- 録音ファイルをアップロードする(対応形式: mp3、wav、m4a、mp4、aac、flac、ogg、wma、webm、mov)
- 文字起こしモデルを選ぶ(既定は「処理速度優先(base)」、固有名詞が多いなら「精度優先(small)」)
- 会議名を入力する(議事録のタイトルとファイル名になります)
- 「▶ 文字起こしを開始」を押す
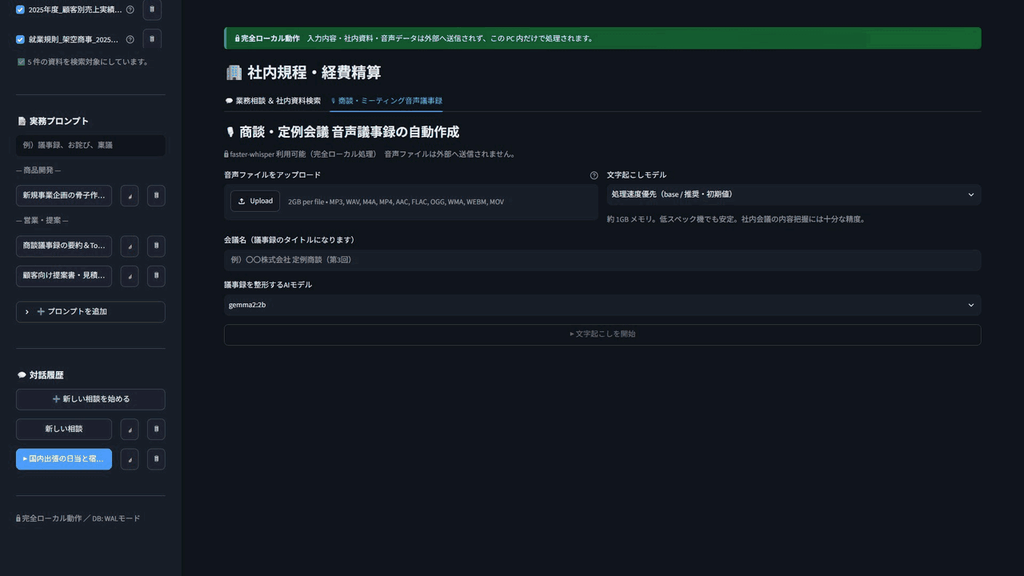
実行中は進捗バーで進み具合が表示されます。完了すると、音声長、認識文字数、区間数、使用モデルの4つが表示され、議事録の生成に進めます。
この記事のGIFで使った音声は、Windows 標準の日本語音声合成で架空の台本(株式会社ダミー商事の定例商談)を読み上げたものです。実在の会議や人物の音声は使っていません。
4. 操作②:4部構成の議事録を自動生成する
「🤖 AIで構造化議事録を作成」を押すと、文字起こしの全文をローカルLLMが読み、次の構成に整形します。
- ① 会議の目的・主要議題
- ② 決定事項(合意内容)
- ③ ToDo・ネクストアクション(担当者・期日・内容の表形式)
- ④ 議論の詳細・発言要旨
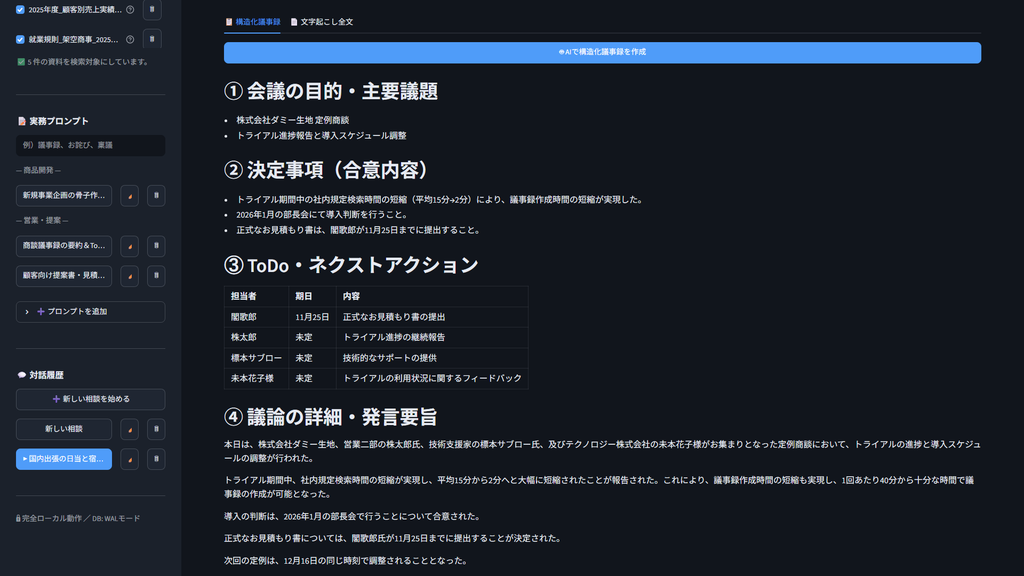
ここで重要なのは、プロンプトに「文字起こしに存在しない決定事項・数値・固有名詞を創作しない」「読み取れない項目は『未定』『(聞き取り不明瞭)』と明記する」という条件が入っていることです。AIが勝手に決定事項を作らない設計になっているので、確認の負担が「創作されていないか」ではなく「誤変換がないか」に絞られます。
5. 操作③:全文タブで原文を確認する
議事録の横には「📄 文字起こし全文」タブがあり、タイムスタンプ付きの全文を確認できます。「📋 構造化議事録」との切り替えはワンクリックです。
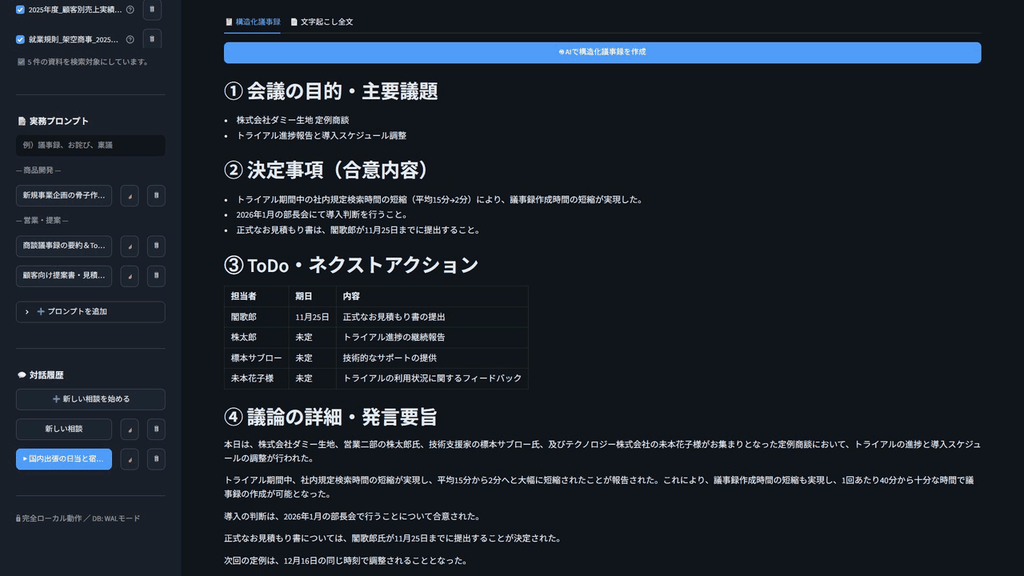
議事録の金額や日付が気になったら、全文タブで該当する発言の時刻を探し、必要なら録音のその位置を聞き直す。この流れが画面内で完結するので、確認作業が速くなります。
6. 操作④:Word・Excel・PowerPoint・Markdownに出力する
生成された議事録は、そのまま次の形式で出力できます。
| タブ | 出力できる形式 |
|---|---|
| 📋 構造化議事録 | Word(.docx)、Markdown(.md)、Excel(.xlsx、ToDo表をシート化)、PowerPoint(.pptx、報告用スライド) |
| 📄 文字起こし全文 | Word(.docx)、Markdown(.md)、タイムライン付きテキスト(.txt) |
「文字起こし全文も同じファイルに含める」にチェックを入れると、議事録の末尾に全文が添付され、1ファイルで配布できます。Excel 出力はToDo表がシートになるので、そのままタスク管理に流用できます。
7. 精度と速度の考え方(baseとsmall)
文字起こしモデルは2択です。
| 選択肢 | 目安 | 向いている場面 |
|---|---|---|
| 処理速度優先(base)〈初期値〉 | メモリ約1GB | 通常の社内定例、内容把握が目的のとき |
| 精度優先(small) | メモリ約2GB、処理時間は2〜3倍 | 専門用語や固有名詞が多い商談、記録を正式文書にするとき |
既定が base なのは、低スペック機でメモリ不足によるクラッシュを防ぐためです。まず base で試し、固有名詞の取りこぼしが目立つ会議だけ small に切り替えるのが現実的です。処理はCPUで行うため、音声の実時間の0.5〜2倍が目安です。1時間の会議なら30分から2時間かかることがあります。構築時の実機検証では、27秒の音声を16秒で処理しています。GPUがあれば速くなりますが、必須ではありません。
議事録を整形するAIモデルも画面で選べます。短い定例なら小さいモデルで十分で、長時間の会議や内容が複雑なときは大きめのモデルを選ぶと要約の質が上がります。長い文字起こしは冒頭約16,000文字を対象に作成し、その旨が議事録に注記されます。全体を対象にしたい場合は音声を分割してください。
8. 運用上の注意:誤変換と確認の手順
音声認識には誤変換が避けられません。構築時の実測(base モデル)では、「価格改定」が「価格回転」、「見積書」が「3つもり書」と認識された例があります。社名や人名も、発音が似た別の語に置き換わることがあります。
そのため、次の確認手順を運用に組み込んでください。
- 議事録の金額・日付・固有名詞を、全文タブと突き合わせる
- 「(聞き取り不明瞭)」「未定」と書かれた箇所は、録音のその位置を聞き直す
- 配布前に担当者が確認し、必要なら Word で修正してから共有する
AIの出力をそのまま社外に出すことは推奨しません。出典と原文を確認できる作りになっているのは、この運用を前提にしているからです。
9. まとめとキットの入手先
- 会議音声をPC内で文字起こしし、4部構成の議事録に自動整形できる。音声データは外部に送信されない
- 決定事項や数値を創作しない条件がプロンプトに入っているため、確認作業は誤変換のチェックに絞られる
- base と small の切り替え、全文タブ、Office 出力で、確認から配布までが画面内で完結する
社内資料の出典付き検索は {U1}、Office 出力とプロンプトテンプレートの詳細は {U3} で解説しています。キットの全体像は総合解説記事をご覧ください。
→ 総合解説記事: {LP_URL}
このアプリは、BOOTHで販売している構築キットの1本目のプロンプトで出来上がるものです。動作確認済みの audio_transcriber.py(約320行)と exporters.py(約620行)も同梱しています。価格 ¥49,800(税込・買い切り)、購入企業内は人数無制限、商用利用可、人的サポートなしです。
→ BOOTH 商品ページ: {BOOTH_URL}
コメント