テストが失敗したとき、AIは「テストを緩める」のではなく「製品を直す」ことができるのか。本記事では、Claude Codeが生成したE2Eテストが71/81項目で失敗した状態から、製品コードのバグ1件とテスト基盤の不備1件を自ら切り分けて修正し、93/93項目PASSに到達した経緯を、テストレポートに残った例外メッセージと修正差分で追います。自治体の課単位運用に直結する「主管課フォルダが切り替わらない」バグの話です。
1. 71/81で止まった1回目のテスト
前回の記事(「外部通信0件」を自動で証明する、E2Eテスト93項目の証跡)で、93項目のE2Eテストがすべて成功したレポートを紹介しました。しかし、その1回前の実行は失敗しています。
テスト結果フォルダには3回分の実行が残っていて、2回目の総合評価は FAIL、81項目中71項目成功・10項目失敗でした。最終的なレポートの「自動検知・自律修正したバグ一覧」には、こう書かれています。
前回実行(71 pass・10 fail)で検知した不具合を解析し、原因を特定のうえ修正しました。本実行はその修正を適用した状態での再テストです。
ここで重要なのは、10件の失敗が「1つの原因」ではなかったことです。Claude Code は失敗を2つに切り分けました。1つは製品コードの本物のバグ、もう1つはテスト基盤側の不備です。この切り分けができないと、製品のバグを「テストが悪い」と誤認して放置するか、テスト基盤の問題を直すために製品コードをいじり壊すかのどちらかになります。
2. バグ1:新しい課のフォルダを作っても元に戻る
このアプリでは、サイドバーの「📁 主管課・業務フォルダ」で課や事業ごとに資料と相談履歴を分けます。「➕ 業務フォルダの新規作成・編集」を開き、「新しい課・事業名」を入力して「フォルダを作成」を押すと、新しいフォルダが作られ、「担当課・事業を選択」のドロップダウンがそのフォルダに切り替わる、という動きが期待値です。
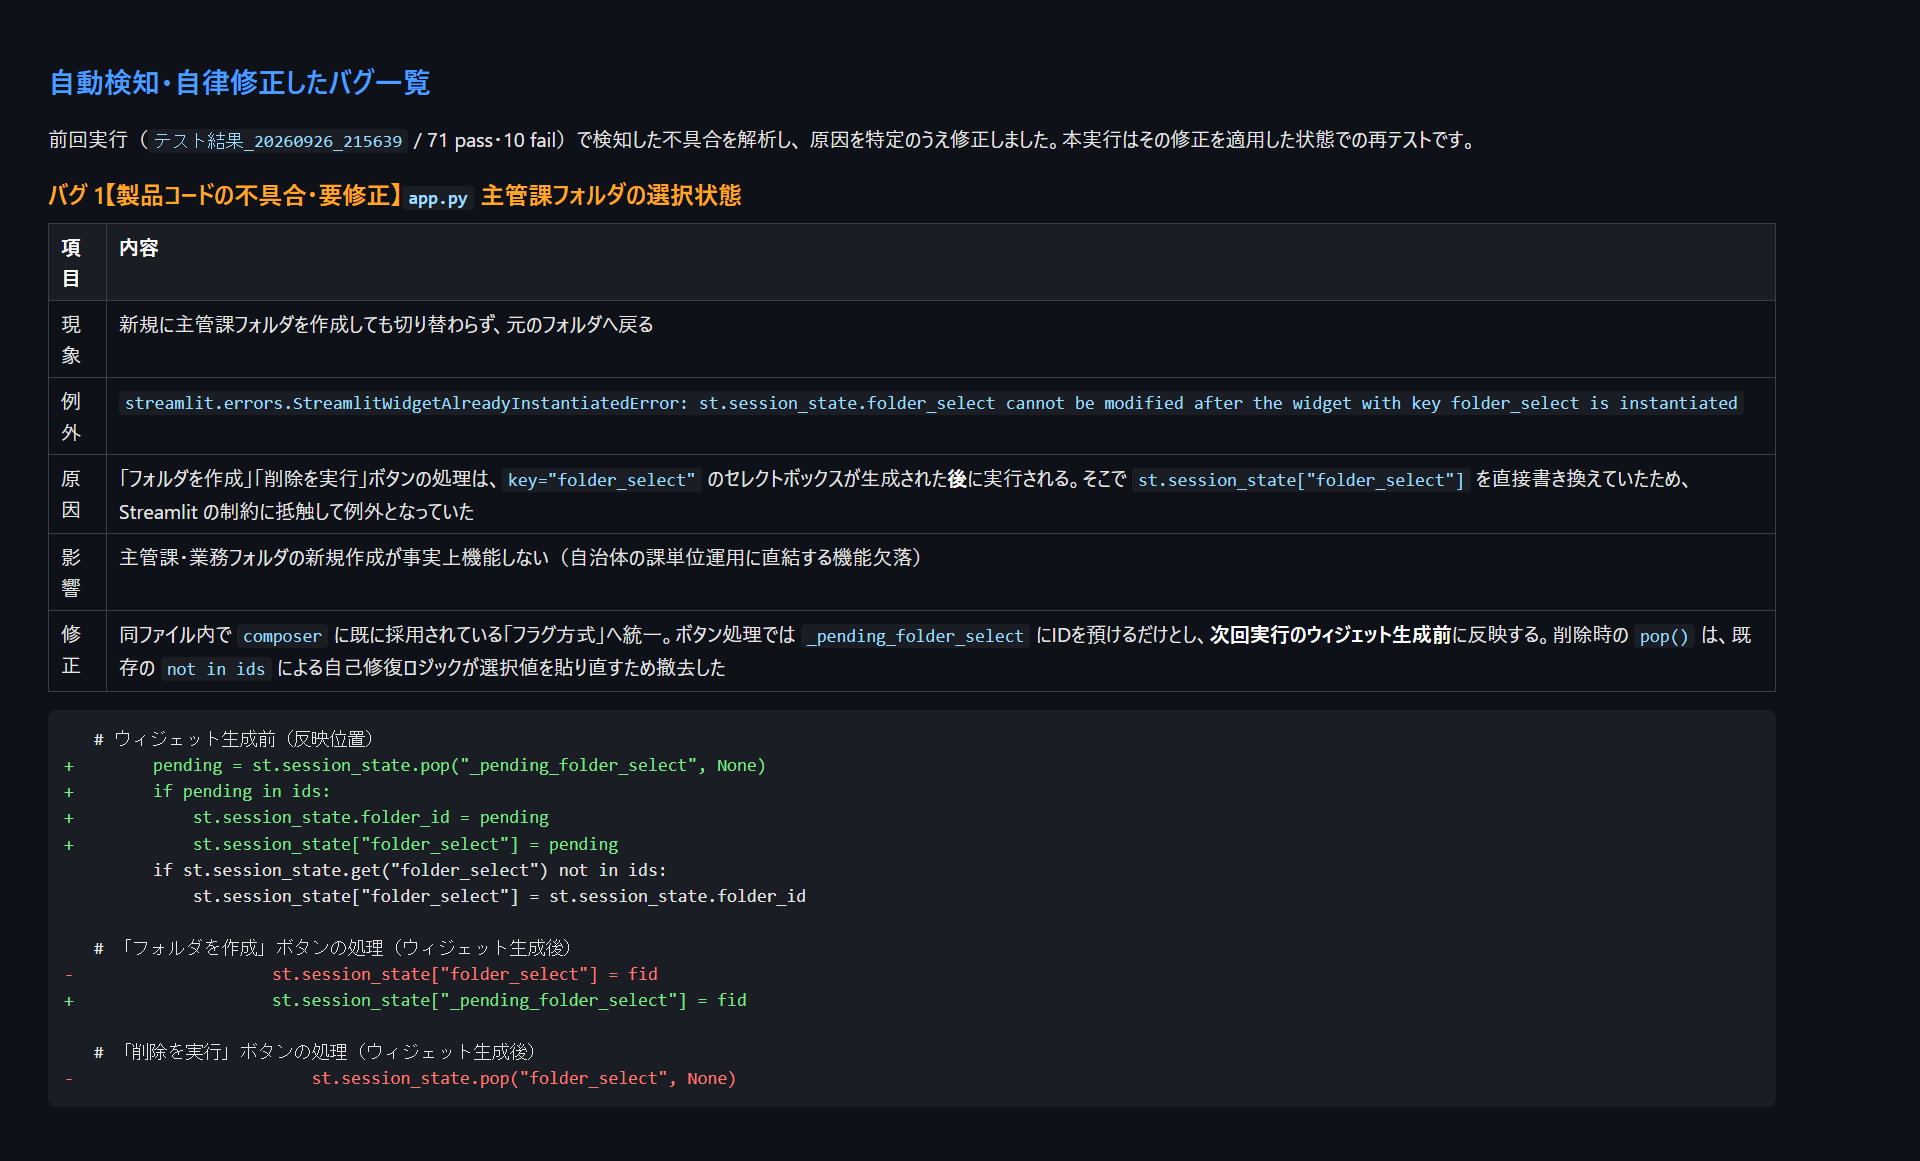
ところが2回目のテストでは、フォルダは作成されるのに選択状態が元のフォルダへ戻ってしまいました。レポートに記録された例外は次のものです。
streamlit.errors.StreamlitWidgetAlreadyInstantiatedError:
st.session_state.folder_select cannot be modified after the widget
with key folder_select is instantiated
影響欄には「主管課・業務フォルダの新規作成が事実上機能しない(自治体の課単位運用に直結する機能欠落)」と書かれています。総務課と情報政策課の資料が混ざらないようにする、というこのアプリの基本機能が、新規作成の経路では壊れていたわけです。
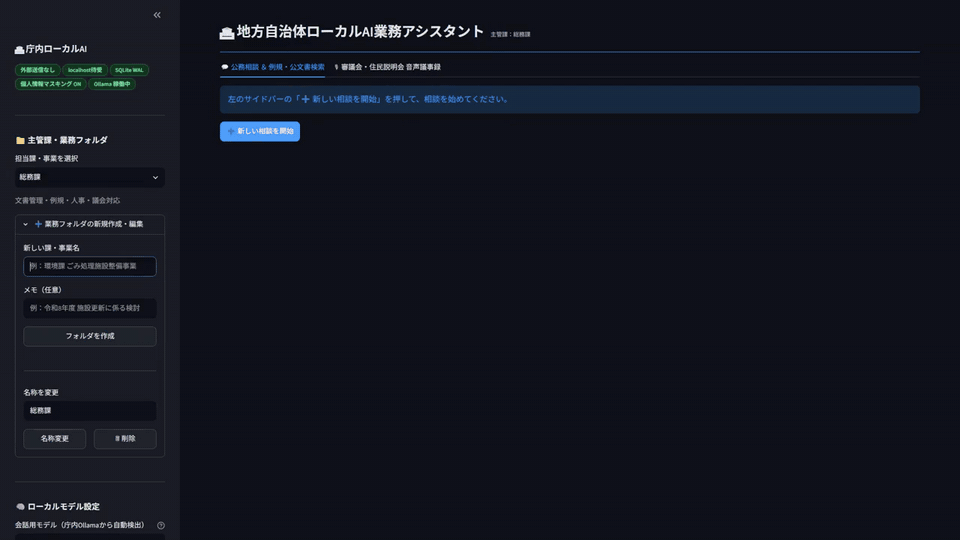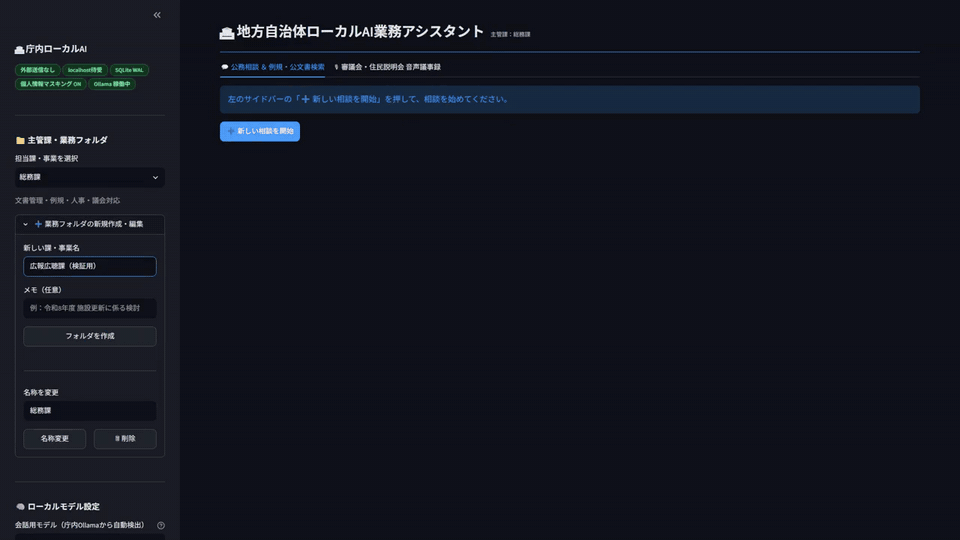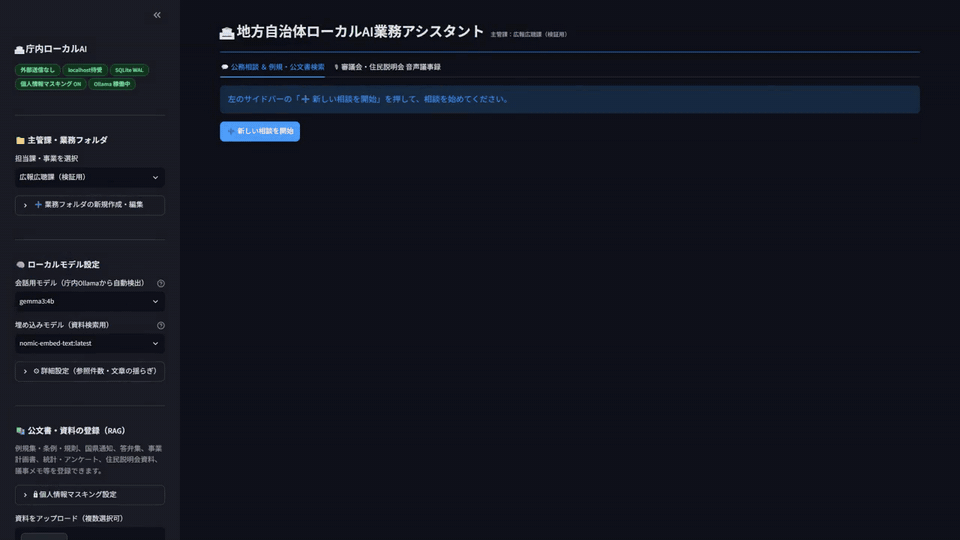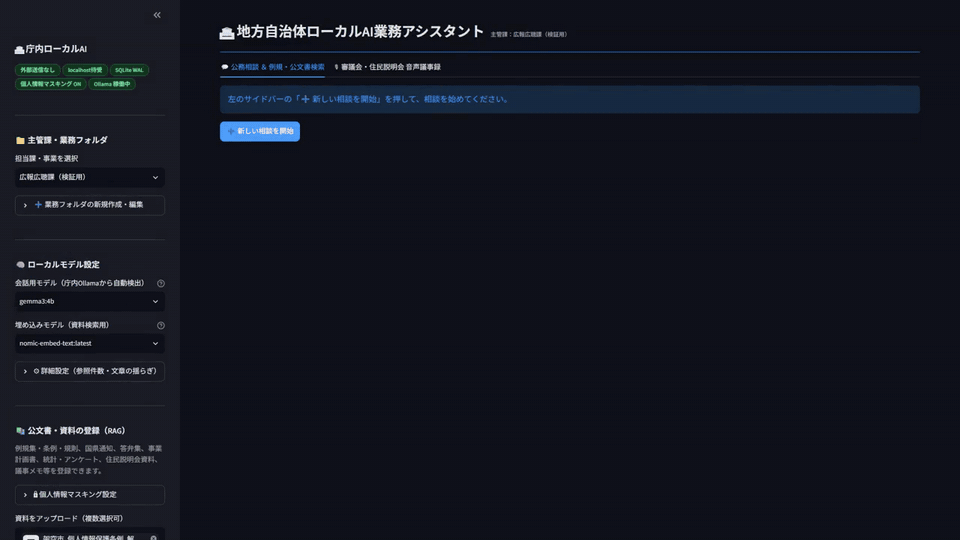
上のGIFは修正後の動作です。入力、作成、切り替わりが一続きで動いています。
3. なぜ起きたか:ウィジェット生成後に状態を書き換えていた
原因は Streamlit の実行モデルにあります。Streamlit はボタンが押されるたびにスクリプト全体を上から再実行します。サイドバーの描画順は「担当課・事業を選択」のセレクトボックスが先、「フォルダを作成」ボタンの処理が後です。
元のコードは、ボタンの処理の中で st.session_state["folder_select"] を直接書き換えていました。しかし key="folder_select" を持つセレクトボックスは、その時点ですでに生成されています。Streamlit は「生成済みのウィジェットに紐づく session_state を同じ実行中に書き換える」ことを禁止しており、それが上記の例外になります。
削除側にも同じ構造の問題がありました。「削除を実行」ボタンの処理で st.session_state.pop("folder_select", None) を呼んでいたのです。
これは Streamlit を使ったことがある人なら一度は踏む落とし穴です。しかし「作成ボタンを押したら選択も切り替える」という自然な要望を満たそうとすると、素直に書けば必ずこの形になります。
4. どう直したか:フラグ方式への統一
Claude Code が選んだ修正は、同じファイル内の別の箇所(入力欄のクリア処理)ですでに使われていた「フラグ方式」に統一することでした。
- ボタンの処理では、選択したいフォルダIDを
_pending_folder_selectという別のキーに預けるだけにする - 次回の再実行で、セレクトボックスが生成される前にそのフラグを取り出し、
folder_selectへ反映する - 削除時の
pop()は撤去する。既存の「選択値が一覧に無ければ現在のフォルダIDを貼り直す」自己修復ロジックが、削除後の選択値を自然に直すため
レポートに残っている差分は、追加4行・置換1行・削除1行の小さなものです。
   # ウィジェット生成前(反映位置)
+        pending = st.session_state.pop("_pending_folder_select", None)
+        if pending in ids:
+            st.session_state.folder_id = pending
+            st.session_state["folder_select"] = pending
         if st.session_state.get("folder_select") not in ids:
             st.session_state["folder_select"] = st.session_state.folder_id

   # 「フォルダを作成」ボタンの処理(ウィジェット生成後)
-                    st.session_state["folder_select"] = fid
+                    st.session_state["_pending_folder_select"] = fid

   # 「削除を実行」ボタンの処理(ウィジェット生成後)
-                        st.session_state.pop("folder_select", None)
注目したいのは、新しい仕組みを発明せず、ファイル内の既存パターンに合わせた点です。人間のレビューで「ここだけ別のやり方になっている」と指摘されない修正になっています。
5. バグ2はテスト基盤側の不備だった
10件の失敗のうち、残りはまとめて別の原因でした。こちらは製品の欠陥ではありません。
テストでは処理時間を120秒以内に収めるため、会話用モデルに軽量な llama3.2:1b を指定します。ところが検証端末の Ollama には18個のモデルが入っており、Streamlit のドロップダウンは仮想スクロールで全選択肢を描画しません。テストスクリプトは role="option" の要素を探していましたが、目的の項目が DOM に存在せず0件。結果として既定の phi4(9GB)のまま推論が走り、1回の応答に約123秒かかってタイムアウト。チャット応答、引用根拠、出力ボタン、議事録生成など7項目が連鎖的に失敗していました。
修正は、コンボボックスに絞り込み文字列を打鍵してから候補を選ぶ方式への変更です。llama3.2:1b と llama3.2-vision:11b が共存するため、完全一致を最優先し、部分一致は次点としました。
レポートはこの件を「テスト基盤の是正」として、製品バグとは別の見出しで記録しています。「製品側の欠陥ではない」と明記されているので、読み手が混同しません。
6. 修正前後の実測値と、再テストの結果
レポートの比較表をそのまま引きます。
| 検証項目 | 修正前 | 修正後 |
|---|---|---|
| 会話用モデルの選択 | phi4:latest のまま |
llama3.2:1b |
| チャット応答の生成 | 約123秒でタイムアウト | 約56秒(1,608文字) |
| 構造化議事録の生成 | 約123秒でタイムアウト | 約27秒 |
| 主管課フォルダ作成 | 例外発生・切替不可 | 例外なし |
| 総合 | 71 / 81 項目(FAIL) | 93 / 93 項目(PASS) |
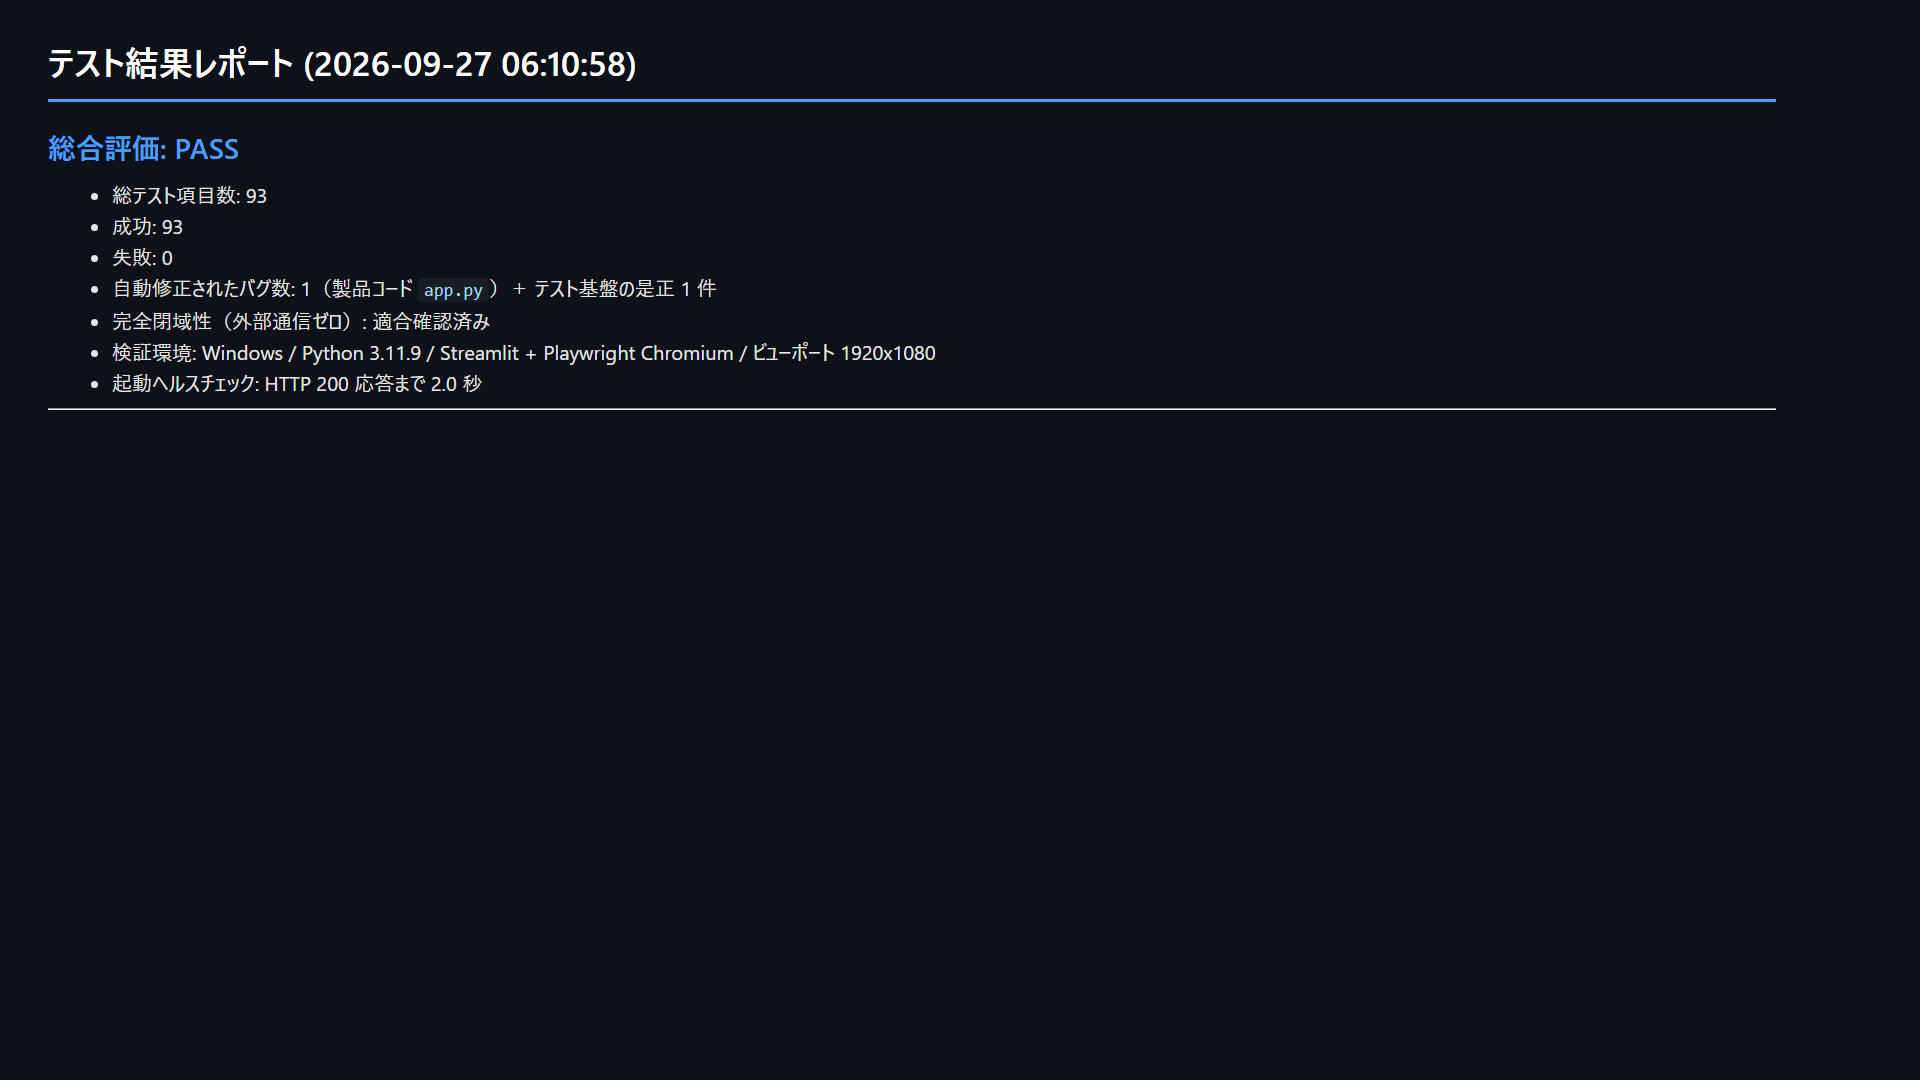
項目数が81から93に増えているのは、修正によって途中で止まらなくなり、後続のセクションまで実行が到達したためです。
レポートには運用上の留意も添えられています。大規模モデルは回答品質に優れる一方で、検証端末では1回の応答に120秒超を要した。これは製品の不具合ではなく、モデル規模と端末性能のトレードオフであり、職員端末の性能に応じたモデル選定を推奨する、という内容です。テストの副産物として、導入時の判断材料が残ったことになります。
7. この「自己修復ループ」はプロンプトで指示できる
ここまでの流れを人間が手でやると、失敗ログを読み、原因を切り分け、コードを直し、もう一度テストを回す、という往復になります。販売キットの 02_E2Eテスト自動化_自動バグ修正プロンプト.md は、この往復そのものを Claude Code に指示しています。
- テストが失敗したら、テストの期待値を緩めるのではなく、まず製品コードの不具合かテスト基盤の不備かを切り分ける
- 製品コードの不具合なら修正し、差分をレポートに残す
- テスト基盤の不備なら、製品コードに触れずにテスト側を是正し、その旨を明記する
- 修正後に全項目を再実行し、修正前後の実測値を比較表で示す
同梱の 03_参考_AI回答例/02_テスト自動化_AI回答例.md には、この一連の実行記録と修正差分がそのまま入っています。参照用コード test_automation_runner.py(約1,800行)には、打鍵絞り込み方式のモデル選択もすでに反映されています。
自分のシステムに応用する場合は、プロンプト内のテストシナリオ(Test 1〜9)を差し替えます。外部通信の監視、サンドボックス方式、証跡の出力、自己修復ループの部分はそのまま使えます。
8. 注意事項と関連記事
本キットは完成品ではなく、Claude Code で構築・テスト・マニュアル生成を行うためのスターターキットです。利用には Claude Code の契約(Anthropic の有料プランまたは API クレジット)、Node.js、Python、Ollama が別途必要です。生成AIの特性上、同じプロンプトでも毎回同じコードは生成されず、本記事のバグと修正も「この実行ではこうなった」という一例です。Ollama で取得するモデル本体のライセンスは本キットとは別です。人的サポートは提供していませんが、トラブルQ&A 12項目を使い方ガイドに収録しています。
価格は 49,800円(税込)、購入組織内の利用人数は無制限、商用利用可、社外への再配布・転売は禁止です。
- 観点A: 外部通信0件を自動で証明するE2Eテスト93項目 → 「外部通信0件」を自動で証明する、E2Eテスト93項目の証跡
- 課題C: 外注は高い、自作は終わらない → 外注は数百万円、自作は終わらない。5万円未満で収まる庁内ローカルAIの作り方
- 総合解説(同梱物・価格・導入手順のまとめ) → データを外に出せない自治体のための完全閉域ローカルAI構築キット
- BOOTH 商品ページ → https://ai-beginner-navi.booth.pm/items/8938066
コメント